LFM2.5-VL-3B : un modèle léger pour l'IA visuelle sur périphérique
- 01LFM2.5-VL-3B est un modèle de vision-langage de 3,1 milliards de paramètres optimisé pour une exécution locale sur périphérique.
- 02Il intègre un encodeur visuel SigLIP2 et un backbone textuel partagé avec LFM2.5-2.6B, entraîné sur 34 000 milliards de tokens.
- 03Le modèle améliore la compréhension d'écrans, la détection d'objets et le raisonnement multi-images, avec des réponses directes pour réduire la latence.
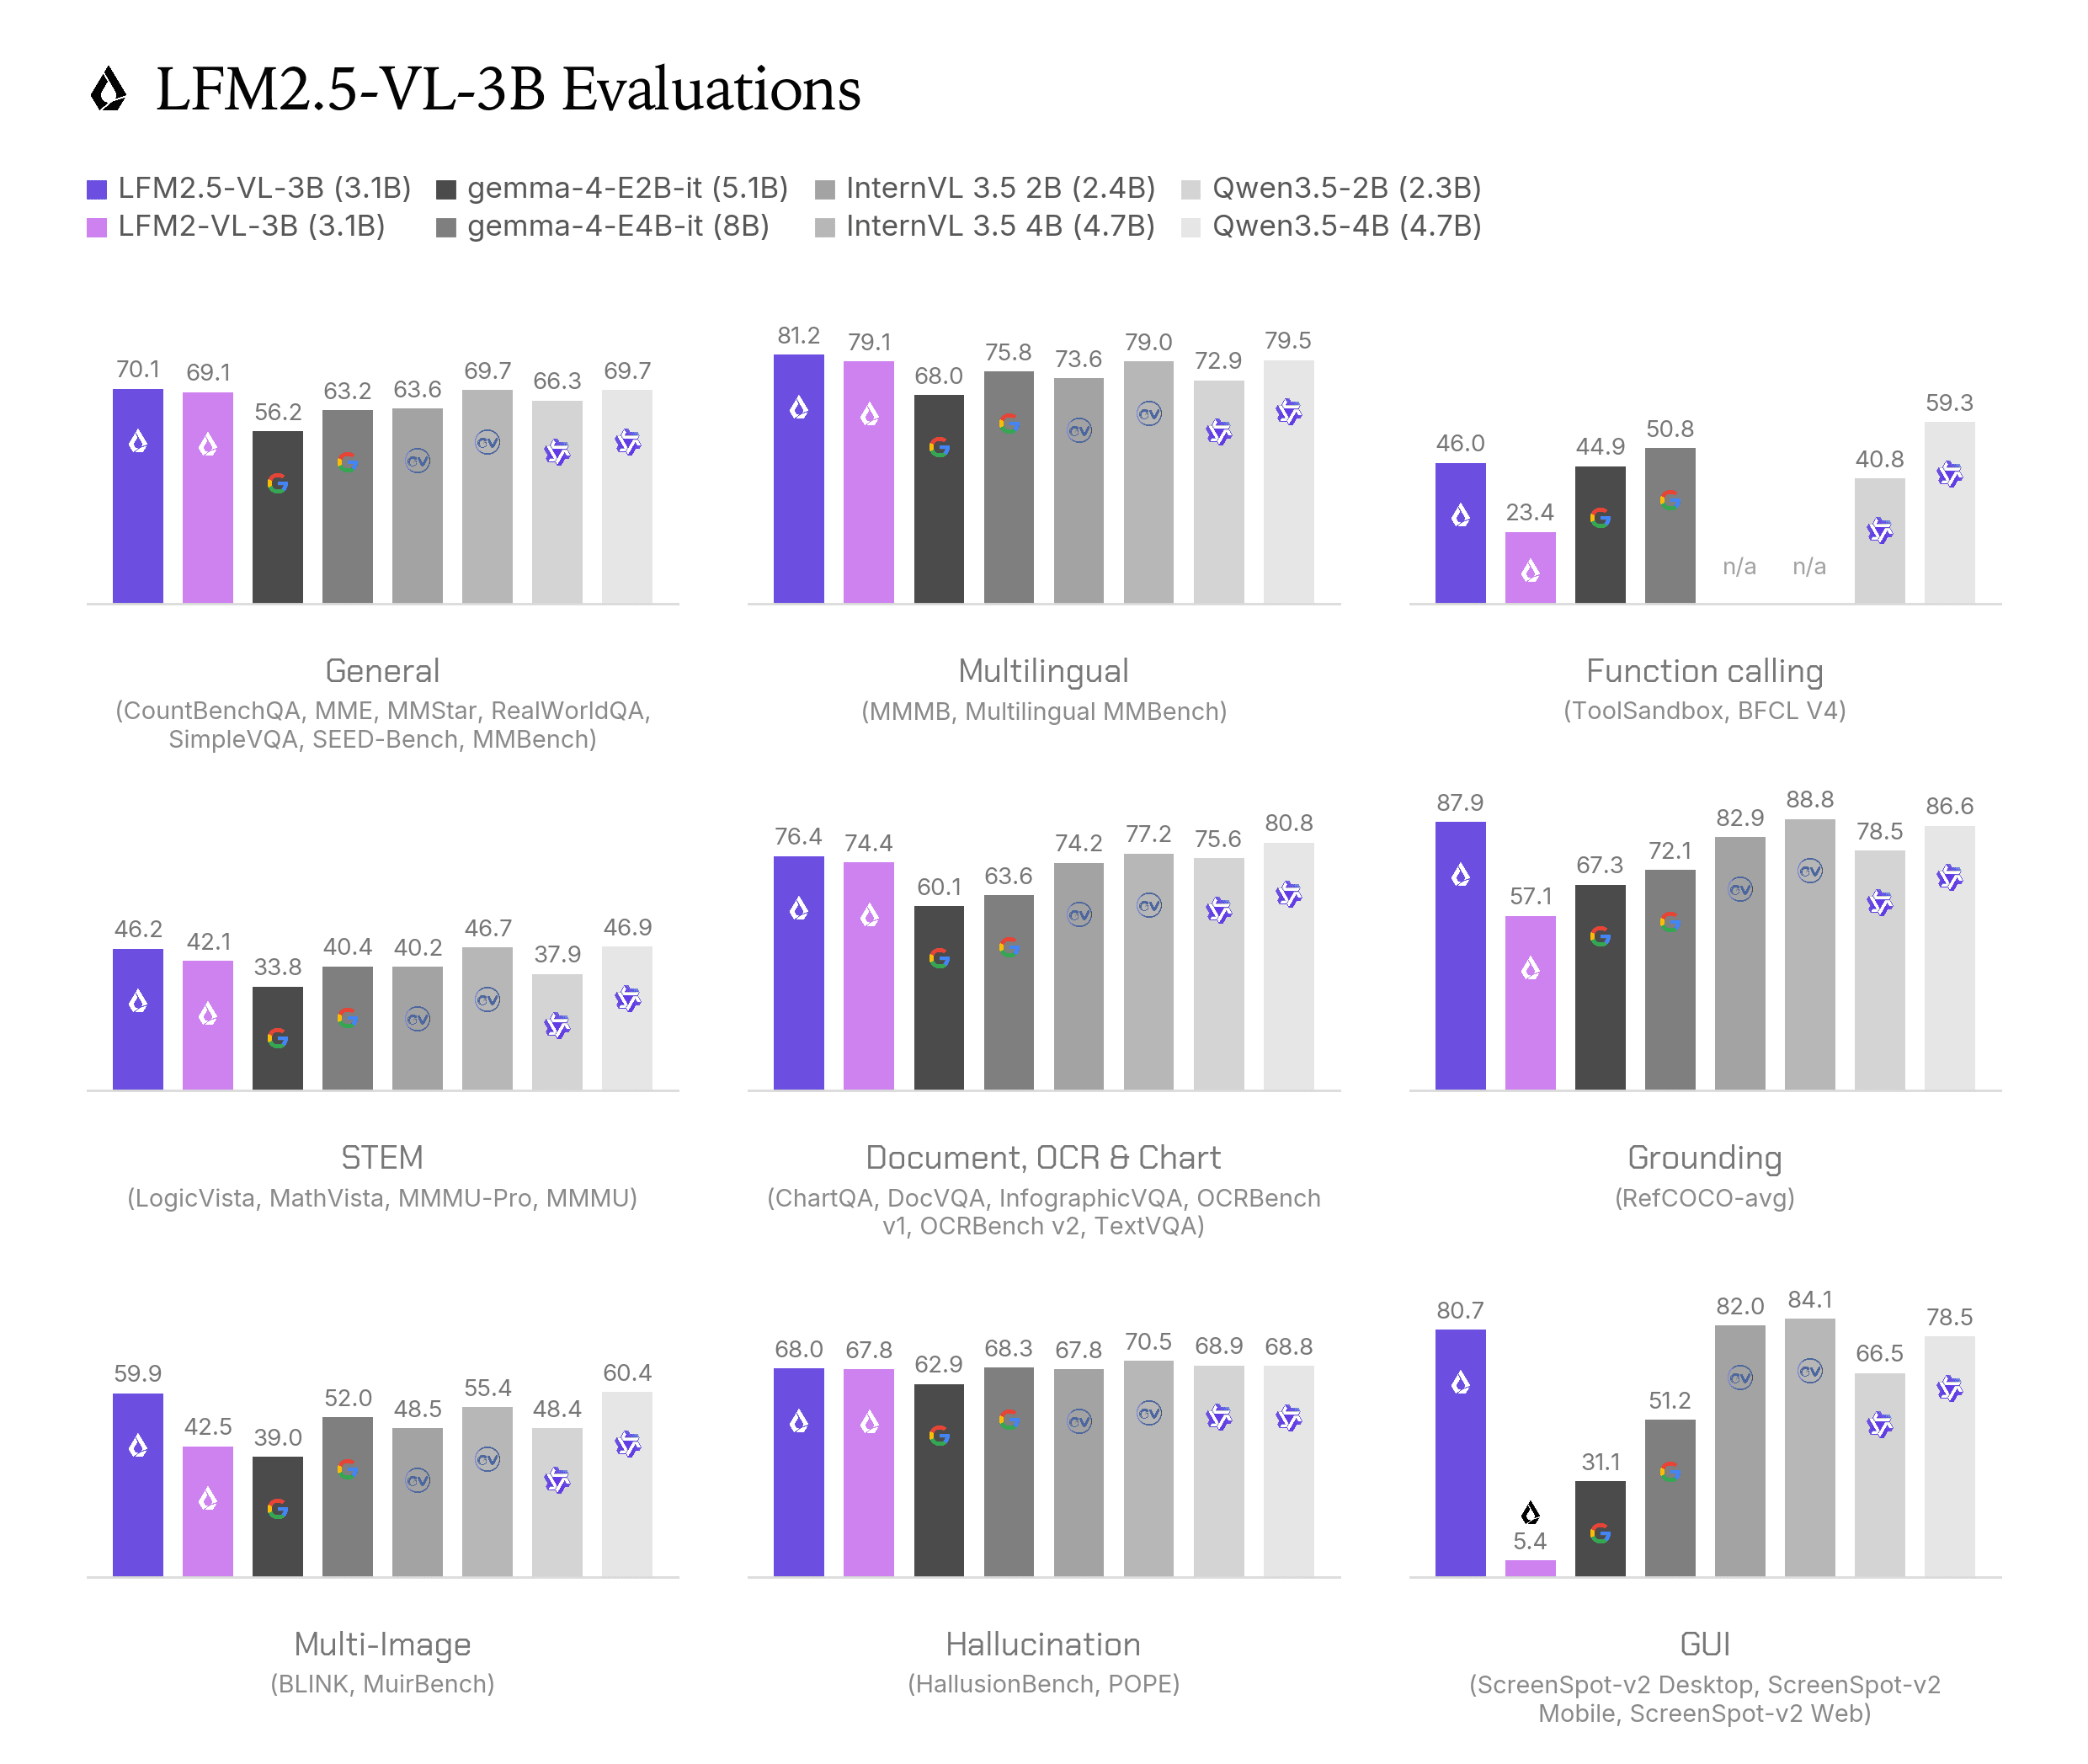
Un nouveau modèle de vision-langage de 3,1 milliards de paramètres, LFM2.5-VL-3B, permet d'exécuter des tâches visuelles avancées directement sur des périphériques locaux, sans dépendre du cloud.
Développé par LiquidAI, LFM2.5-VL-3B combine un encodeur visuel SigLIP2 400M NaFlex avec le même backbone textuel que le modèle LFM2.5-2.6B. Il est entraîné sur environ 34 000 milliards de tokens, avec quatre fois plus de données visuelles que les versions précédentes, incluant des jeux de données d'OCR, de compréhension de documents, de détection d'objets et d'instructions multilingues. Le vocabulaire a été étendu à 128 000 tokens pour supporter davantage de scripts non latins, sans réentraînement complet du tokenizer.
Le modèle se distingue par quatre améliorations majeures : une meilleure compréhension des écrans et interfaces utilisateur, une détection d'objets plus précise avec requêtes en langage naturel, un raisonnement amélioré sur plusieurs images, et une capacité accrue à appeler des outils, y compris en combinant texte et vision. Contrairement à d'autres approches, il génère des réponses directes plutôt que des raisonnements intermédiaires, ce qui réduit la latence pour des applications en temps réel sur appareil.
Les résultats de benchmark montrent que LFM2.5-VL-3B surpasse les modèles de taille similaire sur des tâches visuelles du monde réel, tout en performant bien sur la lecture de contenus numériques comme des documents, des graphiques ou des éléments d'interface. Sur des benchmarks multilingues comme MMMB ou MMBench, il dépasse des modèles concurrents de 2 à 5 milliards de paramètres, notamment en compréhension visuelle et en suivi d'instructions.
LFM2.5-VL-3B est conçu pour être déployé localement, ce qui limite les dépendances externes et améliore la confidentialité des données. Il est disponible en open source sur Hugging Face, avec une démo interactive et des instructions pour son utilisation.