watch·ia
AccueilActusTutosGlossaireCette semaineTendancesSources
/
ACTUS
4 sept. — Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept. — Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept. — Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept. — Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept. — OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept. — Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept. — Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept. — Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept. — Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept. — Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·4 sept. — Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept. — Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept. — Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept. — Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept. — OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept. — Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept. — Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept. — Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept. — Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept. — Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·4 sept. — Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept. — Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept. — Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept. — Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept. — OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept. — Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept. — Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept. — Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept. — Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept. — Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·4 sept. — Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept. — Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept. — Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept. — Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept. — OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept. — Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept. — Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept. — Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept. — Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept. — Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·

LFM2.5-DSpark accélère jusqu’à 3,2 fois l’inférence des modèles LiquidAI

jeudi 20 août 202616:522 min de lecture1 source citée
L'essentiel — 1 point
  • 01LFM2.5-DSpark utilise un décodage spéculatif avec des drafts légers pour accélérer l'inférence jusqu'à 3,2 fois sur certains modèles LiquidAI.
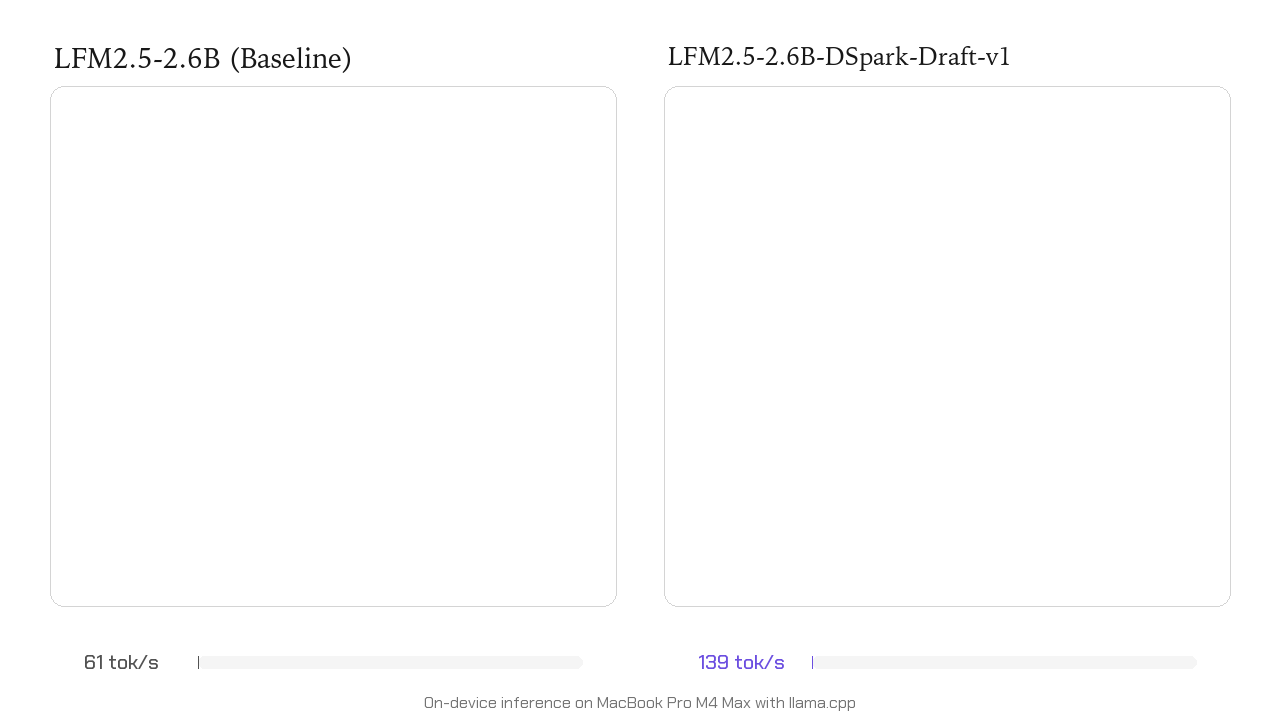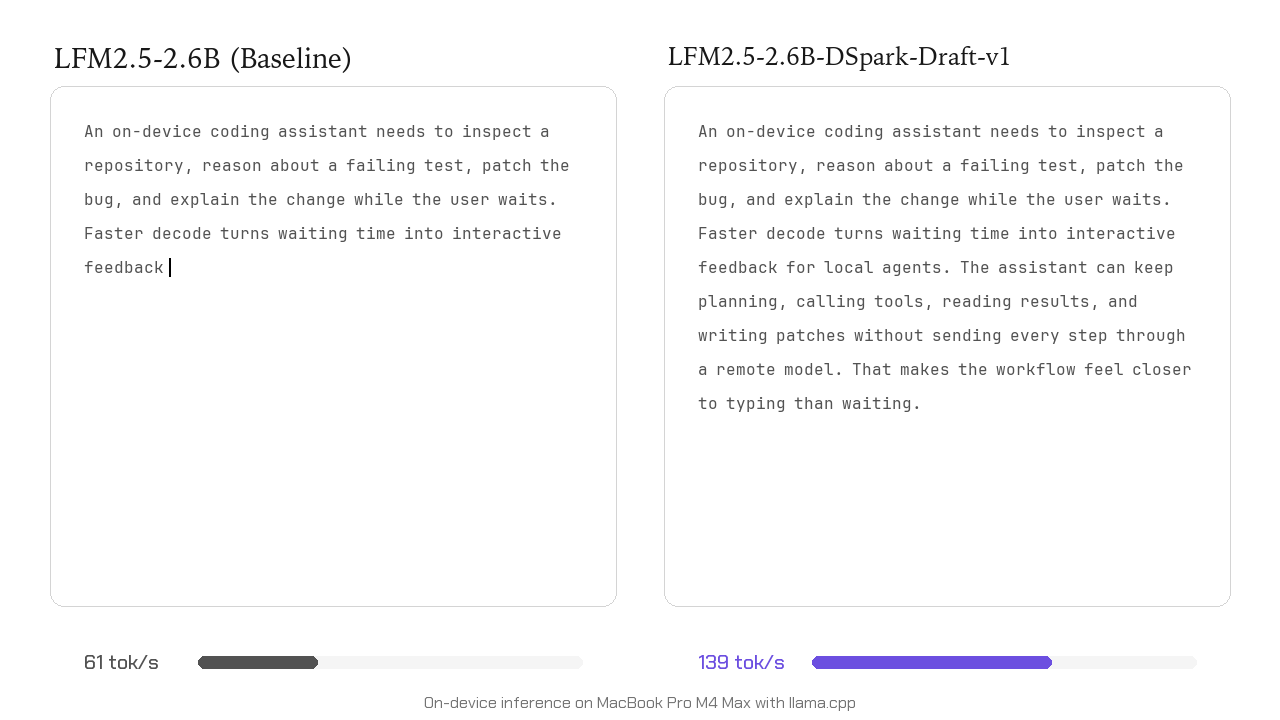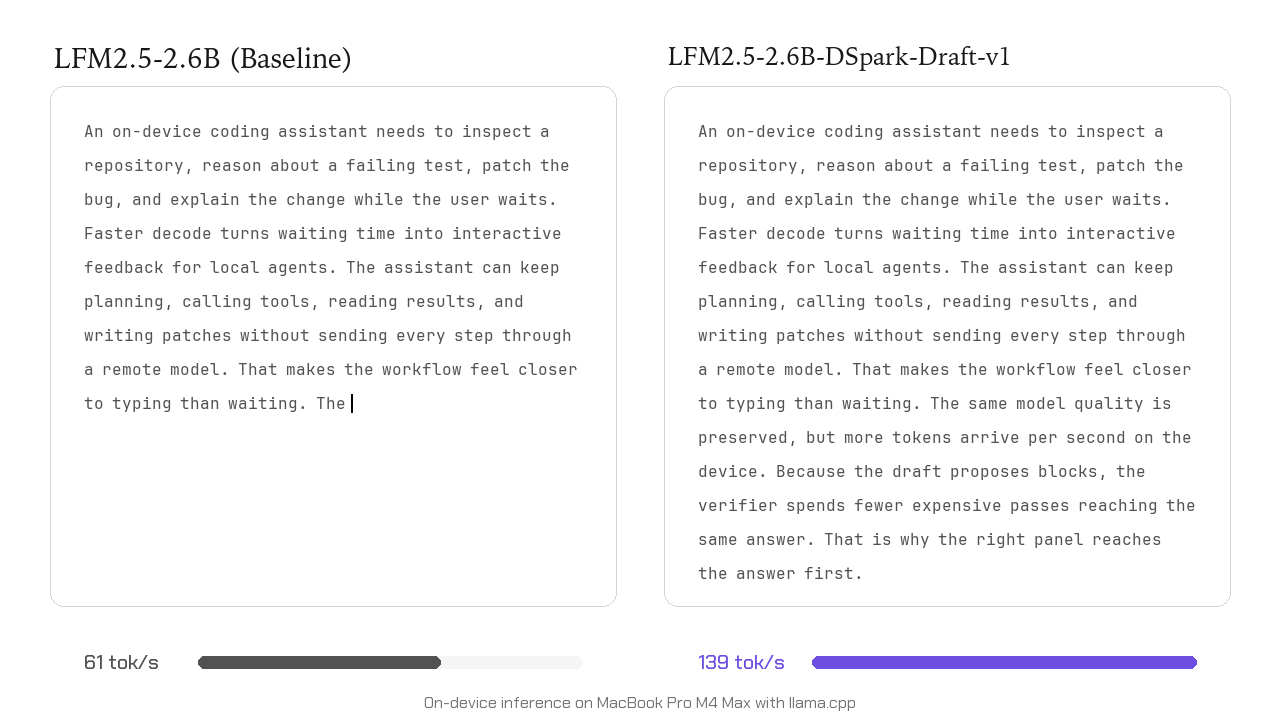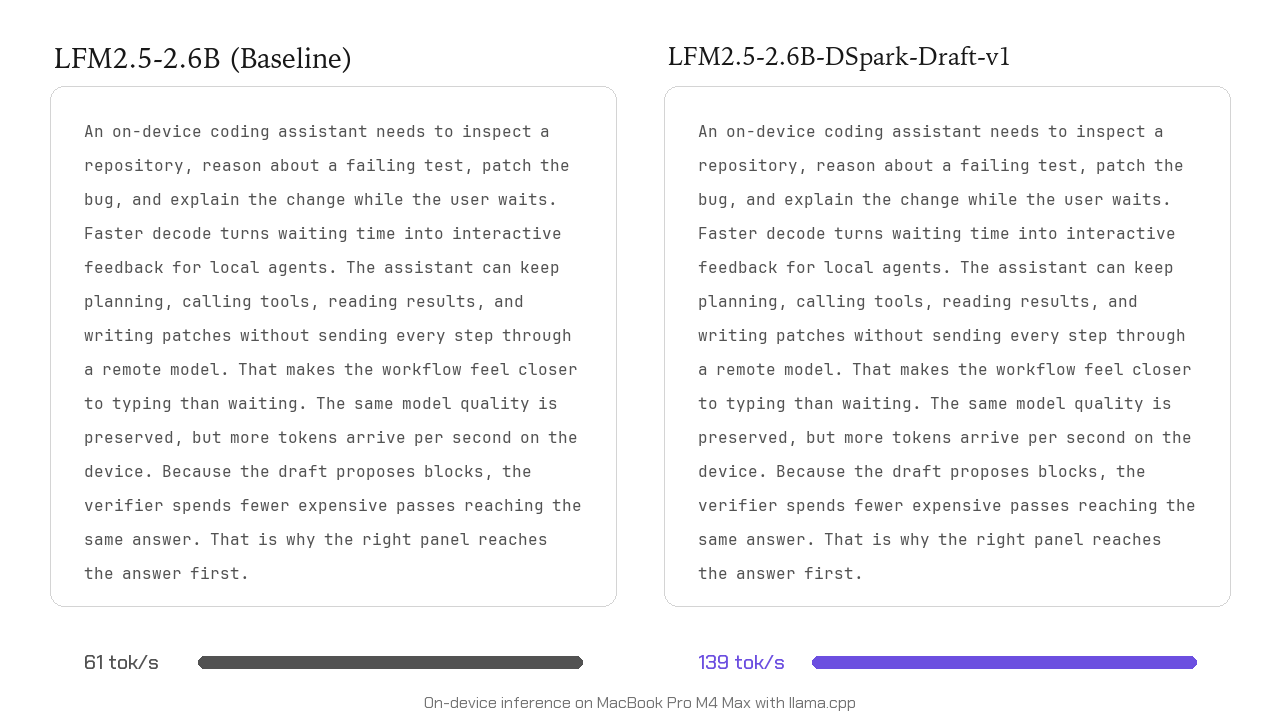
LFM2.5-DSpark accélère jusqu’à 3,2 fois l’inférence des modèles LiquidAI

LFM2.5-DSpark, une extension open source de la famille de modèles LiquidAI, améliore jusqu’à 3,2 fois la vitesse d’inférence pour certains cas d’usage, sans altérer la qualité des réponses générées.

L’outil introduit un mécanisme de décodage spéculatif via des modèles draft légers, intégrés aux modèles LFM2.5-1.2B-Instruct, LFM2.5-2.6B et LFM2.5-8B-A1B. Ces drafts, composés de 5 couches d’attention et d’une tête séquentielle Markov, génèrent des tokens candidats en parallèle. Le modèle cible vérifie ensuite l’ensemble des candidats en une seule passe, réduisant le temps de chargement des poids en mémoire. Les gains mesurés atteignent jusqu’à 3,18 fois sur GPU et 2,87 fois sur appareil mobile, avec une baisse moyenne de 57 % de la latence pour les appels de fonctions avec LFM2.5-2.6B.

L’architecture repose sur trois composants : un backbone parallèle inspiré de DFlash, conditionné par les features du modèle cible ; une tête séquentielle Markov pour renforcer la cohérence des tokens ; et un verificateur à confiance calibrée qui élimine les suffixes peu probables avant vérification. Les drafts, formés sur un mélange de données SFT, chat, code et function-calling, comptent environ 300 millions de paramètres chacun. Leur entraînement privilégie le taux d’acceptation plutôt que la perte, avec 15 époques par version.

L’intégration est immédiate pour llama.cpp et SGLang, via des checkpoints compatibles LFM et open sourcés en amont. La solution cible principalement les environnements où la mémoire est un goulot d’étranglement, comme les déploiements sur appareil ou les inférences à haut débit.

Réagir :
Partager —XLinkedIn
Sources citées