Hugging Face simplifie la distillation de connaissances pour des modèles légers
- 01La distillation de connaissances permet de compresser des grands modèles de langage en modèles plus petits tout en conservant leurs performances.
- 02Hugging Face réduit les coûts de distillation en mettant en cache les top-K logits du modèle enseignant et en optimisant la fonction de perte KL.
- 03Ces modifications permettent d’entraîner des modèles à long contexte sur une seule GPU, rendant la distillation plus accessible.
Hugging Face publie une méthode de distillation de connaissances optimisée pour réduire les coûts de formation des grands modèles de langage.
La distillation de connaissances consiste à entraîner un modèle étudiant plus petit pour qu’il reproduise les performances d’un modèle enseignant plus grand. Cette technique est devenue courante avec l’essor des grands modèles de langage open source, comme gpt-oss, Qwen, GLM ou Kimi, dont les versions récentes nécessitent des ressources matérielles importantes. Par exemple, le modèle Kimi-K3 compte 2,8 billions de paramètres et requiert environ 3 To de VRAM pour être chargé. La compression de ces modèles via distillation permet de réduire leur taille tout en conservant leurs capacités, comme le montrent des initiatives récentes comme Nemotron 3 Puzzle 75B de Nvidia ou Hypernova 60B de Multiverse Computing.
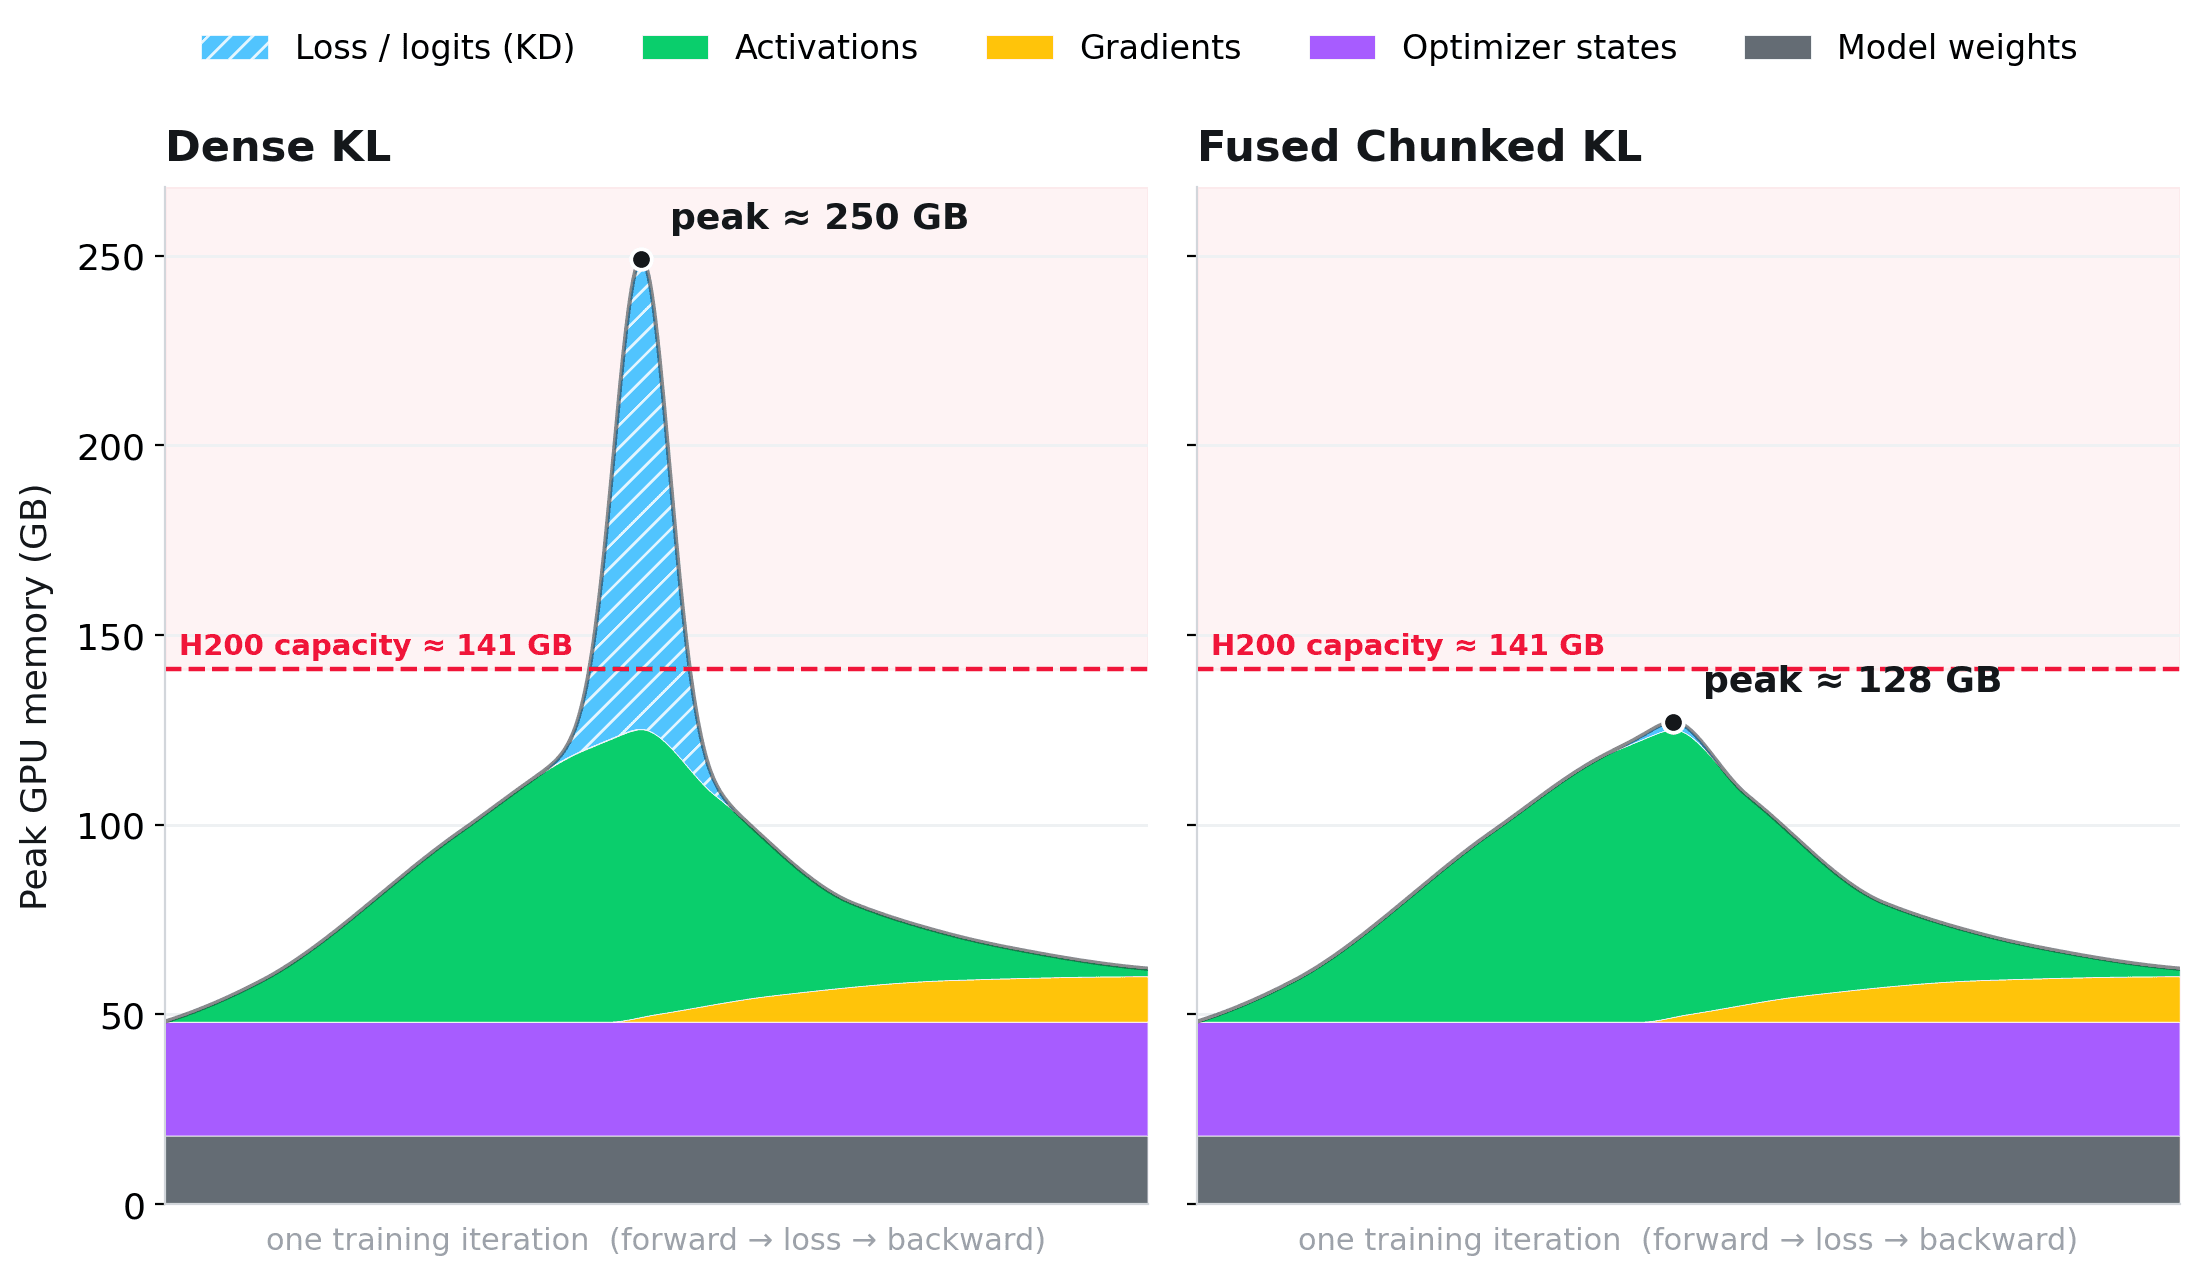
Cependant, l’étape de distillation elle-même est souvent la plus coûteuse du processus. Elle implique de maintenir simultanément les deux modèles en mémoire et de générer une distribution de probabilités sur l’ensemble du vocabulaire pour chaque token. Cette opération nécessite généralement des centaines de GPU et des stratégies complexes de parallélisme tensoriel. Pour y remédier, Hugging Face propose deux modifications techniques dans un article intitulé Efficient Knowledge Distillation for LLMs: Offline Top-K Logits and a Fused Chunked KL Loss.
La première consiste à mettre en cache les top-K logits du modèle enseignant une seule fois, évitant ainsi de devoir le recharger en mémoire à chaque étape d’entraînement. La seconde introduit une nouvelle fonction de perte KL divergente, optimisée pour réduire l’empreinte mémoire en évitant de matérialiser la matrice complète vocabulaire × longueur de séquence. Ensemble, ces deux changements permettent de réduire significativement l’usage de VRAM, rendant possible l’entraînement de modèles à long contexte sur une seule GPU et rendant l’expérimentation à grande échelle plus accessible.
Ces améliorations ciblent directement les limites matérielles actuelles de la distillation, où la mémoire et la puissance de calcul sont souvent des goulots d’étranglement majeurs.
Articles liés
Hugging Face intègre l'hindi et l'anglais indien à son classement ASR open
Pour les développeurs travaillant sur des modèles multilingues, cette intégration élargit les possibilités de reconnaissance vocale.
Nvidia annonce le rachat de Hugging Face pour 12,9 milliards de dollars
Nvidia renforce son contrôle sur l'écosystème open source des modèles d'IA avec l'acquisition de la plateforme Hugging Face.

Hugging Face commercialise le robot canard open source Microduck à 399 $
Un robot open source et programmable est proposé aux développeurs pour un prix accessible.