Hugging Face combine Inference Endpoints, Jobs et Buckets pour Papers with Code
- 01Papers with Code utilise désormais un moteur de recherche hybride combinant recherche lexicale et sémantique.
- 02Jobs transforme les données brutes en corpus de vecteurs, Buckets gère le stockage, et Inference Endpoints traite les requêtes en temps réel.
- 03La recherche hybride améliore la pertinence des résultats par rapport aux approches purement lexicales ou vectorielles.
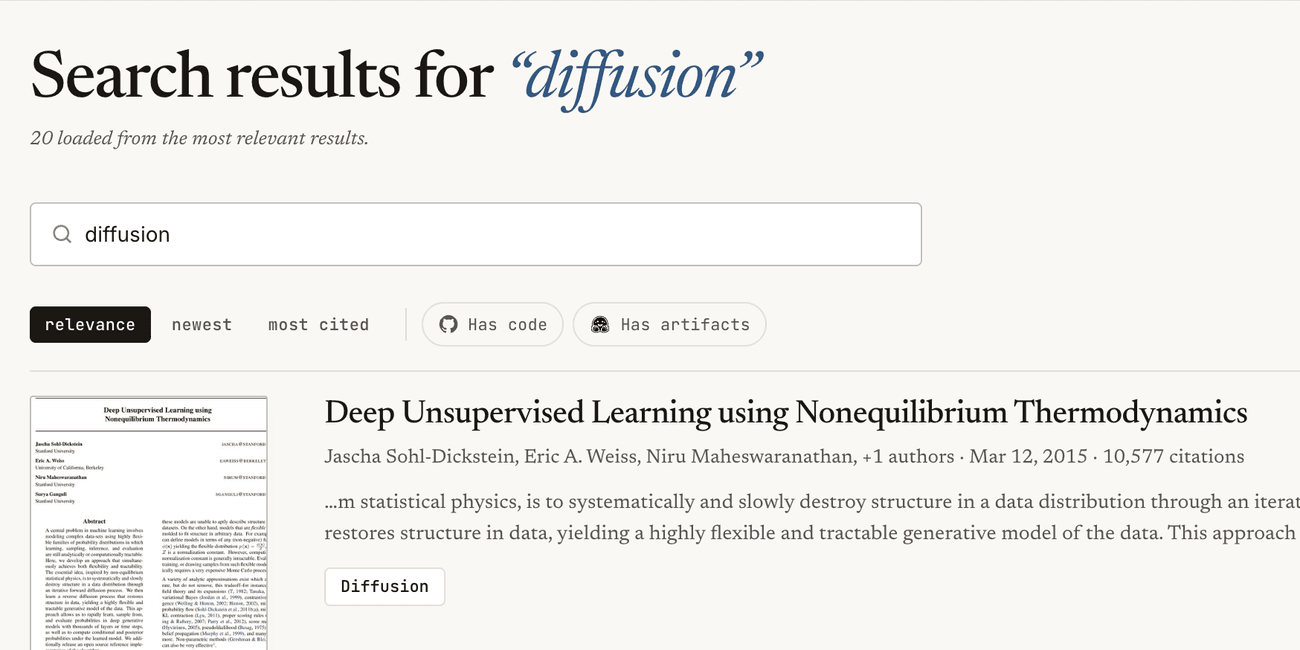
Hugging Face annonce l’intégration de ses outils Inference Endpoints, Jobs et Buckets pour renforcer le moteur de recherche de Papers with Code, une plateforme dédiée à l’accessibilité de la recherche en IA.
Le moteur de recherche de Papers with Code repose désormais sur un système hybride combinant recherche lexicale et recherche sémantique. La recherche lexicale s’appuie sur les capacités full-text de PostgreSQL, tandis que la recherche sémantique utilise des embeddings denses via pgvector. Cette approche hybride permet de traiter des requêtes variées : recherche exacte par titre ou identifiant arXiv, mais aussi compréhension de requêtes floues comme « petits modèles de langage pour la génération de code », même si les termes ne sont pas présents ensemble dans un article. Le système doit également gérer des cas comme la reconnaissance d’un titre incomplet ou de fautes de frappe, tout en garantissant des temps de réponse rapides, même en cas de redémarrage d’un service.
Pour alimenter ce moteur, Hugging Face utilise trois composants clés. Jobs permet de transformer des instantanés de bases de données en corpus de vecteurs, en appliquant des modèles d’embeddings sur l’ensemble des données. Buckets sert d’interface entre le stockage et le calcul, en garantissant un contrat explicite entre les deux. Enfin, Inference Endpoints place la recherche sémantique sur le chemin des requêtes, en traitant les embeddings en temps réel. Cette architecture permet une mise à jour continue des embeddings, tout en maintenant une latence maîtrisée. Les résultats montrent que la recherche hybride dépasse les performances des approches purement lexicales ou vectorielles, en combinant précision et pertinence sémantique.
L’équipe souligne plusieurs enseignements tirés de ce déploiement. Elle recommande de séparer les tâches sensibles à la latence des travaux de débit, et de concevoir le stockage comme un contrat explicite entre les couches de calcul et de production. Elle insiste aussi sur l’importance de figer plus que le seul nom du modèle utilisé, et de prévoir des mécanismes pour les démarrages à froid. Enfin, l’optimisation des vecteurs et la stabilité des activations sont présentées comme des leviers systèmes majeurs pour maintenir les performances.
Articles liés
Hugging Face intègre l'hindi et l'anglais indien à son classement ASR open
Pour les développeurs travaillant sur des modèles multilingues, cette intégration élargit les possibilités de reconnaissance vocale.
Nvidia annonce le rachat de Hugging Face pour 12,9 milliards de dollars
Nvidia renforce son contrôle sur l'écosystème open source des modèles d'IA avec l'acquisition de la plateforme Hugging Face.

Hugging Face commercialise le robot canard open source Microduck à 399 $
Un robot open source et programmable est proposé aux développeurs pour un prix accessible.