- 01BenchMIRT, développé par AllenAI, analyse les benchmarks des LLM au niveau des questions individuelles pour identifier les capacités réellement évaluées.
- 02L'outil utilise la théorie de la réponse à l'item multidimensionnelle (MIRT) pour séparer les signaux des questions et éviter les biais liés à l'agrégation des scores.
- 03Les données d'entraînement couvrent 100 LLM, 16 benchmarks et plus de 34 000 questions, avec des résultats accessibles en open source et sur Hugging Face.
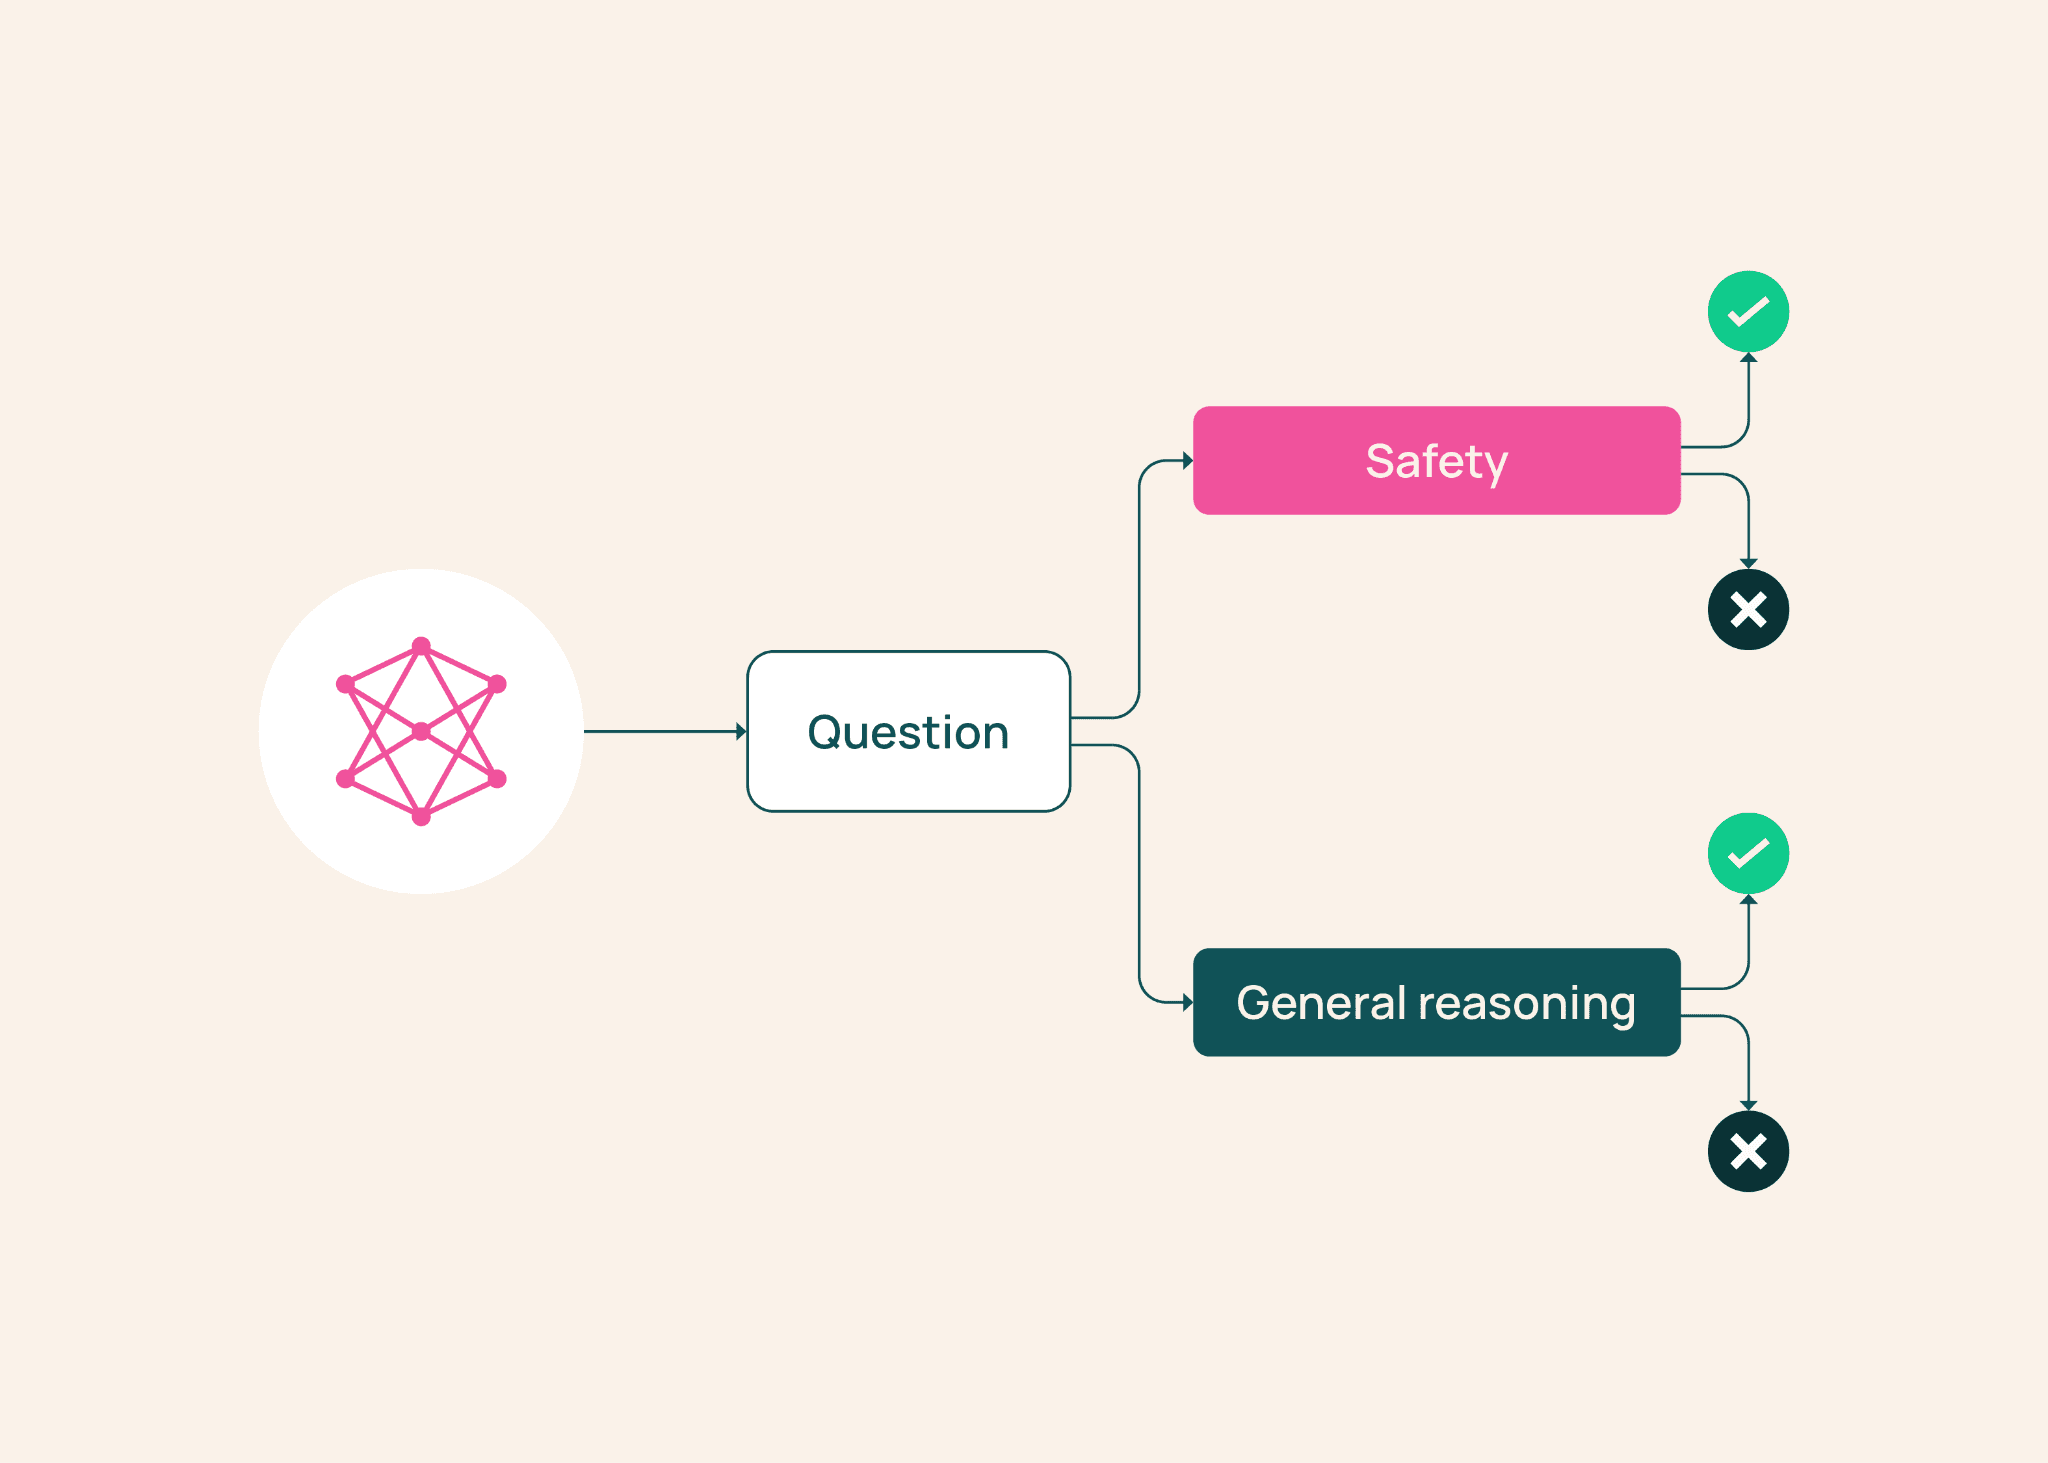
AllenAI présente BenchMIRT, une méthode d'audit des benchmarks dédiés aux grands modèles de langage (LLM) au niveau des questions individuelles. L'outil vise à identifier les capacités sous-jacentes réellement évaluées par ces benchmarks, souvent conçus pour mesurer une compétence spécifique comme la sécurité ou le raisonnement général.
Les benchmarks actuels agrègent des questions variées, dont certaines peuvent mesurer des aptitudes différentes de celles annoncées. Par exemple, le benchmark BBQ, conçu pour évaluer les biais sociaux, inclut une question sur un petit-fils et un grand-père tentant de réserver un Uber. Cette question teste à la fois les stéréotypes liés à l'âge et la capacité à suivre des informations contextuelles. De même, WildJailbreak mélange des prompts malveillants et des prompts inoffensifs pour tester la résistance aux jailbreaks ou le refus excessif de requêtes anodines. Ces différences de nature entre questions rendent les scores agrégés peu représentatifs des compétences ciblées.
BenchMIRT s'appuie sur la théorie de la réponse à l'item (IRT), une méthode issue de la psychométrie, pour analyser les performances modèles par modèle et question par question. Contrairement à une approche unidimensionnelle, BenchMIRT utilise une version multidimensionnelle (MIRT), capable de distinguer plusieurs capacités simultanément. Par exemple, une question peut solliciter à la fois le raisonnement logique et la compréhension du contexte, ce que BenchMIRT identifie en estimant la difficulté de chaque question et sa capacité à discriminer les modèles performants de ceux moins performants.
L'outil a été entraîné sur les résultats de 100 LLM évalués sur 16 benchmarks totalisant plus de 34 000 questions. Les données utilisées proviennent de benchmarks variés, couvrant des compétences comme la sécurité, le raisonnement général ou le suivi d'instructions. BenchMIRT permet ainsi de cartographier les forces et faiblesses des modèles au-delà des scores globaux, offrant une granularité inédite dans l'évaluation des LLM.
Les résultats sont disponibles sous forme de collections Hugging Face, de code open source et d'un rapport technique détaillant la méthodologie et les données.
Articles liés
OlmoEarth Studio permet désormais d'exporter des embeddings personnalisés pour l'analyse géographique
Présentation des nouvelles fonctionnalités d'export d'embeddings pour l'analyse en aval avec OlmoEarth.

Import AI publie 23 propositions pour évaluer les risques de l'automatisation de la R&D en IA et lance PostTrainBench+
Découvrez les propositions de l'auteur pour améliorer l'évaluation des modèles d'IA et explorez PostTrainBench+, un nouvel outil de benchmarking.
Import AI détaille PostTrainBench et 23 propositions pour encadrer l'automatisation de la R&D en IA
Import AI analyse des outils comme PostTrainBench et des concepts comme les RSI dans le paysage concurrentiel de l'IA.