Hugging Face publie un guide pour affiner des modèles en 100 étapes avec GRPO
- 01Hugging Face publie un guide pour affiner un modèle de 350M de paramètres en 100 étapes avec GRPO et TRL.
- 02Le fine-tuning améliore la conformité des sorties sur le benchmark IFStruct, de 22,6 % à 29,7 %.
- 03Le processus est conçu pour être exécuté sur un GPU gratuit (Colab/Kaggle) et évaluable localement avec llama.cpp.
Hugging Face publie un guide technique pour affiner un modèle de 350 millions de paramètres en 100 étapes avec GRPO, une méthode optimisée pour améliorer la production de sorties structurées.
Le billet de blog détaille une procédure de fine-tuning appliquée au modèle LFM2.5-350M à l’aide de GRPO et de la bibliothèque TRL. L’objectif est d’améliorer la conformité des sorties du modèle à un schéma prédéfini, mesurée par le benchmark IFStruct. Le processus complet nécessite environ 500 échantillons et 100 étapes d’entraînement, ce qui le rend exécutable sur un GPU de niveau gratuit comme ceux proposés par Colab ou Kaggle. Le code et les instructions sont disponibles sur GitHub.
Les résultats montrent une amélioration de la performance sur IFStruct, passant de 22,6 % à 29,7 % après fine-tuning. Le benchmark IFStruct évalue spécifiquement la capacité des modèles à générer des sorties valides et parseables selon un format demandé, une exigence cruciale pour l’intégration dans des systèmes en aval. Contrairement à d’autres approches, cette méthode ne vise pas à reproduire le score exact du benchmark IFStruct, mais à démontrer qu’un fine-tuning ciblé sur des modèles de taille réduite peut rivaliser avec des modèles bien plus grands.
La procédure est divisée en deux parties : le fine-tuning, qui s’exécute sur GPU, et l’évaluation, réalisable localement sur un ordinateur comme un MacBook équipé d’un processeur Apple M5 Max. L’évaluation utilise llama.cpp pour servir le modèle via une interface compatible OpenAI, tandis que le fine-tuning repose sur des outils comme uv pour la gestion des dépendances Python.
Articles liés

NVIDIA NeMo Automodel et Hugging Face Diffusers s’allient pour le fine-tuning vidéo et image
Nouvel outil pour entraîner des modèles de génération vidéo et image via une intégration entre NVIDIA NeMo Automodel et Hugging Face Diffusers.
NeoMME : un encodeur multimodal multilingue open source sans tour de vision séparée
Explorer une innovation open-source majeure pour les modèles d'IA polyvalents.
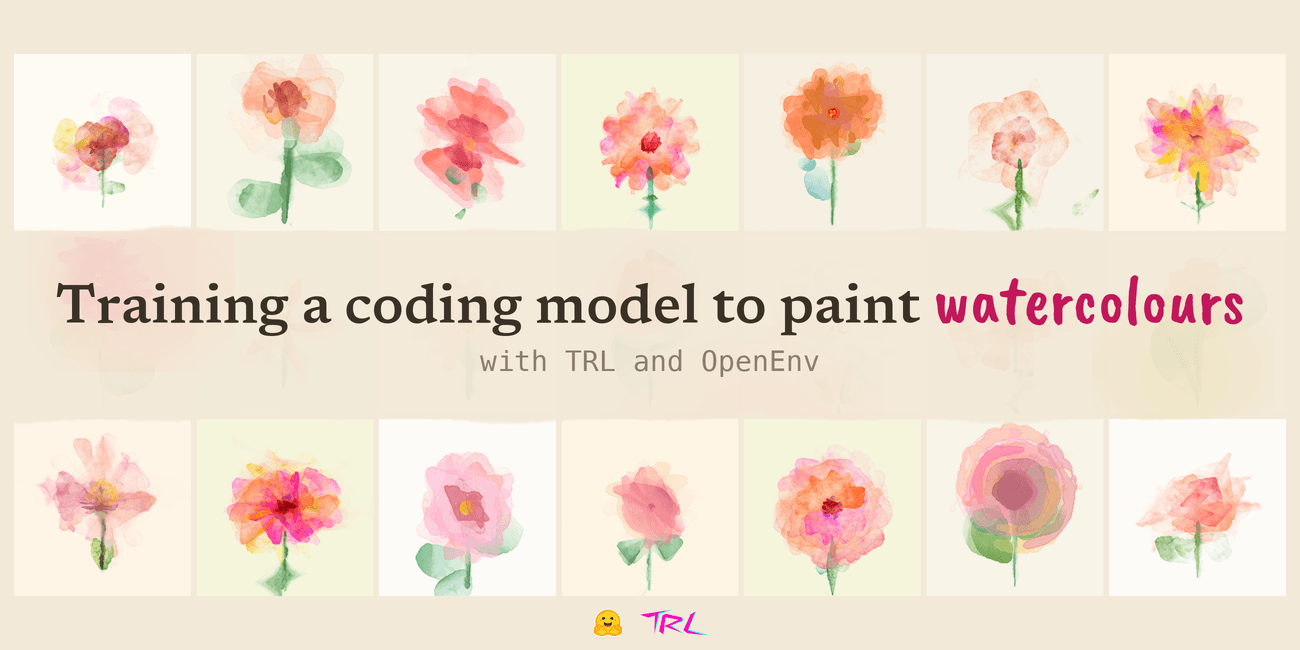
Hugging Face publie un modèle open source générant des aquarelles via du code
Découvrez comment Hugging Face combine génération de code et peinture numérique avec un modèle open source.