NeoMME : un encodeur multimodal multilingue open source sans tour de vision séparée
- 01NeoMME est une famille d’encodeurs multimodaux multilingues de 260M et 800M de paramètres, entraînés *from scratch* sans tour de vision séparée ni modèle de langage causal.
- 02NeoMME-Retriever génère en un passage des embeddings denses et tardifs pour le retrieval de documents visuels, avec un débit de 51 pages/seconde (GPU NVIDIA L40S) pour le modèle 260M.
- 03La quantification asymétrique et le *pooling* hiérarchique réduisent le stockage des index de 1,5 Mo à 6 Ko/page (255× moins) sans perte significative de performance (nDCG@10 > 95 % du baseline).
Hugging Face annonce NeoMME, une famille d’encodeurs multimodaux et multilingues de 260 millions et 800 millions de paramètres, conçus pour traiter simultanément texte et images sans recourir à une tour de vision préentraînée ni à un modèle de langage causal.
Contrairement aux approches classiques qui combinent un encodeur visuel distinct et un projetor pour aligner les modalités, NeoMME repose sur un unique Transformer bidirectionnel capable d’ingérer directement des patches d’images brutes et des tokens de texte. Le modèle est entraîné from scratch avec un objectif de diffusion discrète masquée, optimisé pour générer des représentations vectorielles unifiées. Deux variantes de taille (260M et 800M) sont proposées, toutes deux positionnées sur la frontière de Pareto ViDoRe v3 pour le score nDCG@10 et la taille du modèle.
Pour le retrieval de documents visuels, Hugging Face propose NeoMME-Retriever, une version fine-tunée exploitant l’approche page-image de ColPali. Ce modèle produit en un seul passage avant des embeddings denses et des représentations pour une interaction tardive, avec une latence réduite. À taille d’entrée d’image équivalente (2048×2048) sur un GPU NVIDIA L40S, le modèle 260M encode environ 51 pages par seconde, soit près du double du débit de ColModernVBERT. Une stratégie de pooling hiérarchique et une quantification asymétrique permettent de réduire le stockage des index pour l’interaction tardive de 1,5 Mo à 6 Ko par page (255 fois moins), tout en conservant plus de 95 % du score nDCG@10 de référence.
Disponible via Hugging Face Transformers, NeoMME est distribué sous licence Apache 2.0, avec l’ensemble des poids et des outils associés (démos, rapports techniques) accessibles dans une collection dédiée. L’objectif affiché est de proposer une alternative légère aux architectures VLM traditionnelles, en éliminant les surcoûts computationnels et paramétriques liés aux tours de vision séparées ou aux décodeurs causaux.
Articles liés
Hugging Face publie un guide pour affiner des modèles en 100 étapes avec GRPO
Découvrez une méthode de fine-tuning optimisée pour générer des sorties structurées avec des modèles de taille réduite.
Hugging Face publie plus de 200 kernels WebGPU pour accélérer l'IA locale dans le navigateur
Découvrez comment optimiser vos modèles d'IA locaux avec les nouveaux kernels WebGPU de Hugging Face.
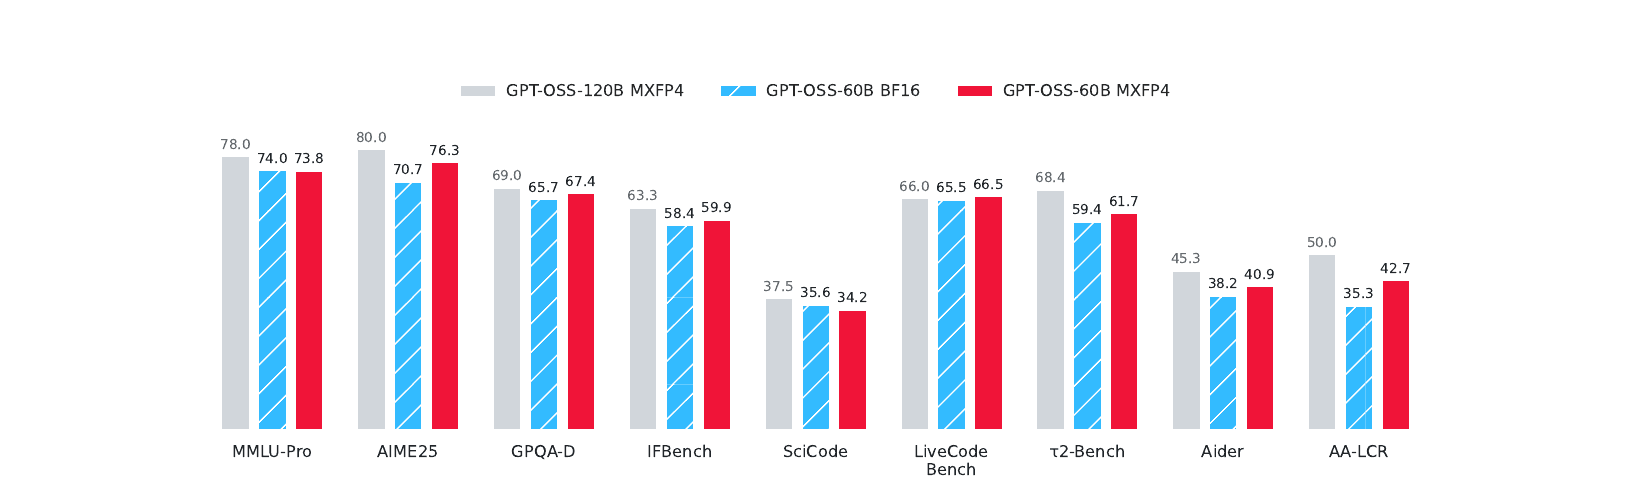
Hugging Face et MultiverseComputingCAI dévoilent une quantification 4-bit plus précise que les modèles originaux
Découvrez une technique de compression d'IA qui réduit les coûts de calcul sans perte de performance.