watch·ia
AccueilActusTutosGlossaireCette semaineTendancesSources
/
ACTUS
4 sept.Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept.Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept.Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept.Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept.OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept.Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept.Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept.Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept.Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept.Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·4 sept.Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept.Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept.Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept.Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept.OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept.Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept.Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept.Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept.Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept.Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·4 sept.Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept.Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept.Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept.Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept.OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept.Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept.Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept.Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept.Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept.Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·4 sept.Crusoe lève 3 milliards de dollars pour une valorisation de 30 milliards·3 sept.Accel en pourparlers pour diriger une levée de 1 milliard chez Thinking Machines·3 sept.Abliteration.ai propose des modèles IA sans restrictions via une plateforme commerciale·3 sept.Meta propose des réductions pour partager les données d’usage de Muse Spark·3 sept.OpenAI présente GPT-6 Astra, son modèle le plus avancé à ce jour·3 sept.Ollie lance un assistant IA familial conforme SOC 2 pour préserver la confidentialité·3 sept.Nvidia propose PAIR, un outil gratuit pour agréger des PC locaux en cluster d'inférence IA·3 sept.Google ajoute des modes vocaux en temps réel pour Gmail, Docs et Keep·3 sept.Panne simultanée de ChatGPT, Grok et Claude : trois assistants IA majeurs inaccessibles·3 sept.Google améliore son modèle météo IA WeatherNext 3 avec une résolution cinq fois supérieure·

Hugging Face et MultiverseComputingCAI dévoilent une quantification 4-bit plus précise que les modèles originaux

mardi 25 août 202611:392 min de lecture1 source citée
L'essentiel — 3 points
  • 01QAH compresse un modèle GPT-OSS 120B en 60B paramètres puis le quantifie en 4 bits (MXFP4).
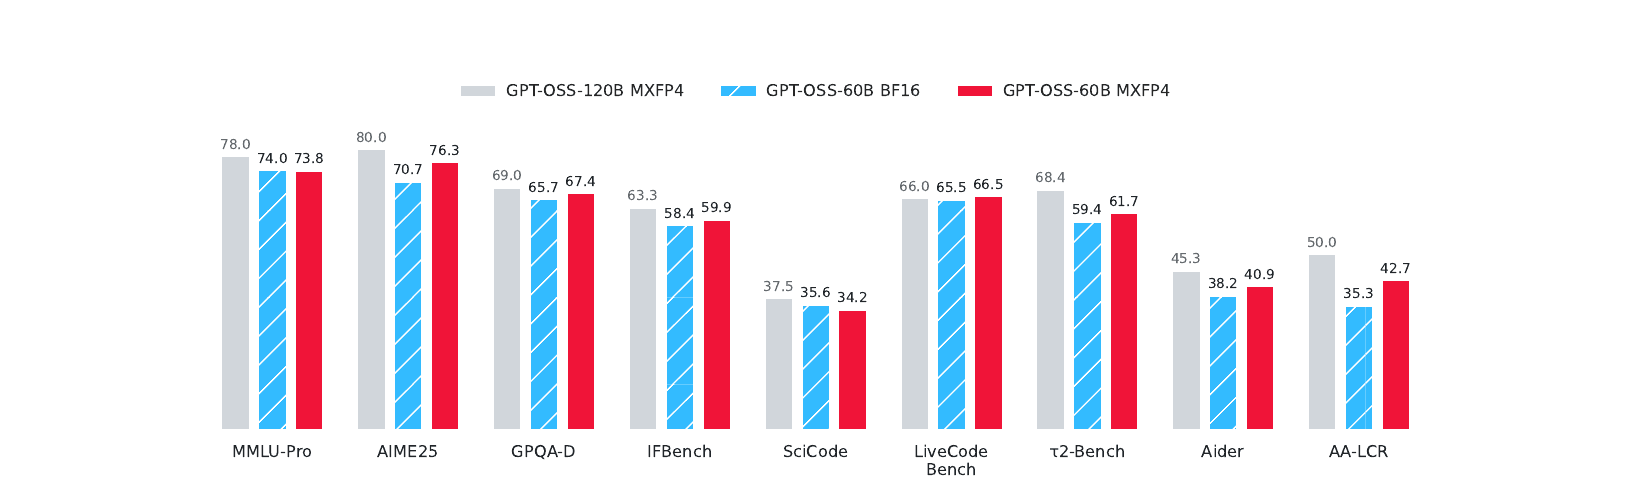
  • 02Le modèle résultant est plus petit, moins coûteux et plus précis que sa version en précision pleine sur 7 des 9 benchmarks.
  • 03QAH évite les limites des méthodes QAT et QAD en optimisant spécifiquement la phase de récupération après compression et quantification.
Hugging Face et MultiverseComputingCAI dévoilent une quantification 4-bit plus précise que les modèles originaux

Hugging Face et MultiverseComputingCAI annoncent Quantization-Aware Healing (QAH), une méthode de quantification 4-bit qui améliore les performances d'un modèle compressé par rapport à sa version en précision pleine.

La technique QAH s'inscrit dans un pipeline classique de compression : réduction de l'architecture (ici, passage d'un GPT-OSS 120B à 60B paramètres), quantification des poids en 4 bits (MXFP4), puis une étape de healing pour compenser les pertes de performance. Contrairement aux méthodes existantes comme la Quantization-Aware Training (QAT) ou la Quantization-Aware Distillation (QAD), QAH optimise spécifiquement la phase de récupération après une compression structurelle suivie d'une quantification.

Les résultats montrent qu'un modèle GPT-OSS 120B compressé à 60B et quantifié en 4 bits surpasse son équivalent en précision pleine (bfloat16) sur 7 des 9 benchmarks testés. Le modèle final est à la fois plus petit, moins coûteux en calcul et plus performant que la version originale dont il est issu. Cette approche inverse la relation habituelle entre un modèle 4-bit et son ancêtre 16-bit, où la version compressée est généralement moins performante.

Les auteurs soulignent que les méthodes de healing existantes comme QAT ou QAD présentent des limites. QAT nécessite de relancer un processus coûteux de fine-tuning sur des données bruitées en basse précision, ce qui peut dégrader la stabilité si l'entraînement se prolonge au-delà du point optimal. QAD, bien que moins gourmand, repose sur une distillation depuis un modèle enseignant en précision pleine, ce qui limite son efficacité dans des scénarios où le modèle original n'est plus disponible ou trop lourd à exploiter.

Réagir :
Partager —XLinkedIn
Sources citées