Hugging Face publie plus de 200 kernels WebGPU pour accélérer l'IA locale dans le navigateur
- 01Hugging Face publie 207 kernels WebGPU optimisés pour l'IA locale, hébergés sur le Hugging Face Hub.
- 02Chaque kernel inclut son interface, ses tests de correction, ses benchmarks et ses shaders WGSL, garantissant une reproductibilité totale.
- 03L'outil Fleet permet de benchmarker ces kernels dans le navigateur et de crowdsourcer des données de performance et de correction.
Hugging Face annonce la publication de @huggingface/kernels, une bibliothèque JavaScript permettant d’exécuter localement des kernels WebGPU optimisés pour l’inférence d’IA directement dans le navigateur. La plateforme met à disposition 207 kernels hébergés sur le Hugging Face Hub, couvrant des opérations clés comme les multiplications matricielles, les convolutions ou les primitives d’attention, essentiels pour une large gamme d’architectures de modèles d’IA.
Chaque kernel est distribué sous forme de paquet versionné et autonome, incluant son interface, ses tests de correction, ses cas de benchmark, ainsi que les templates de shaders WGSL. Cette approche garantit une reproductibilité totale et permet aux développeurs de vérifier la fiabilité et les performances des kernels sur leur matériel. La bibliothèque @huggingface/kernels agit comme un chargeur minimaliste, téléchargeant et exécutant ces kernels depuis le Hub sans dépendance lourde. L’objectif affiché est de maximiser l’efficacité des opérations GPU tout en assurant une portabilité entre différents appareils et implémentations de navigateurs.
Pour compléter cette initiative, Hugging Face lance Fleet, un outil de benchmarking intégré au navigateur. Fleet évalue les performances et la correction des kernels sur le matériel de l’utilisateur, tout en collectant anonymement des données de performance et de fiabilité via une contribution communautaire. Ces retours permettent d’identifier des cas de résultats incorrects, des ralentissements anormaux ou des variantes de kernels à optimiser, améliorant ainsi la qualité globale de la collection.
Articles liés
NeoMME : un encodeur multimodal multilingue open source sans tour de vision séparée
Explorer une innovation open-source majeure pour les modèles d'IA polyvalents.
Hugging Face publie un guide pour affiner des modèles en 100 étapes avec GRPO
Découvrez une méthode de fine-tuning optimisée pour générer des sorties structurées avec des modèles de taille réduite.
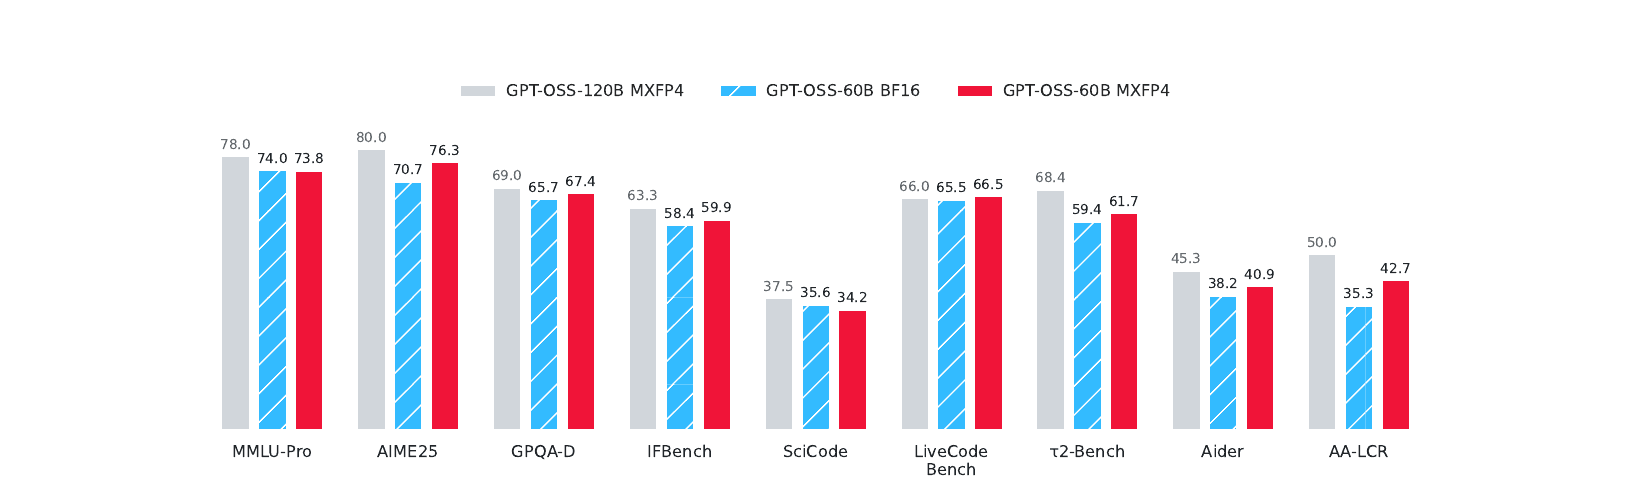
Hugging Face et MultiverseComputingCAI dévoilent une quantification 4-bit plus précise que les modèles originaux
Découvrez une technique de compression d'IA qui réduit les coûts de calcul sans perte de performance.